로컬 AI용 맥미니는 CPU 코어 수보다 통합 메모리 용량을 먼저 정해야 합니다. Ollama나 LM Studio로 가벼운 모델만 실행한다면 16GB도 가능하지만, Docker·워드프레스·AI 에이전트를 함께 운영할 계획이라면 24GB 이상이 현실적인 기준입니다.
처음부터 30B급 모델과 장기적인 로컬 AI 개발까지 고려한다면 M4 Pro 48GB 또는 64GB가 적합합니다. 반대로 Claude·GPT·Gemini API를 주로 사용할 예정이라면 비싼 메모리 옵션보다 M4 16GB 또는 24GB에 SSD와 외장 저장장치를 보강하는 편이 합리적입니다.
가벼운 로컬 AI와 API 개발은 M4 24GB를 추천합니다.
로컬 LLM을 꾸준히 실행하려면 M4 Pro 48GB가 안정적입니다.
대형 모델과 여러 AI 에이전트는 M4 Pro 64GB 이상을 고려해야 합니다.
맥미니에서 RAM이 중요한 이유
Apple Silicon 맥미니는 CPU, GPU, AI 연산 장치가 통합 메모리를 함께 사용합니다. 일반 데스크톱처럼 시스템 RAM과 그래픽카드 VRAM이 분리되어 있지 않기 때문에, 로컬 LLM을 실행하면 모델 파일과 macOS, Ollama, Docker, 브라우저, 작업 프로그램이 같은 메모리를 나눠 사용합니다.
따라서 “16GB RAM이면 16GB 모델을 실행할 수 있다”고 보면 안 됩니다. 운영체제와 백그라운드 앱이 사용할 공간을 남겨야 하며, 모델의 가중치 외에도 컨텍스트, KV 캐시, 실행 프로그램을 위한 메모리가 필요합니다.
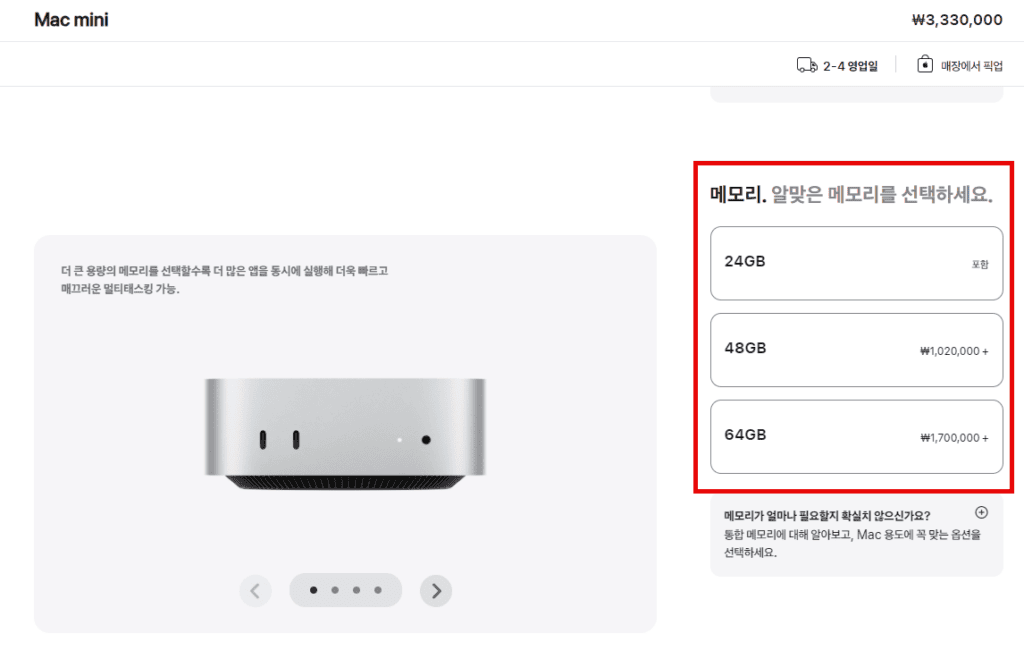
로컬 AI 초보자는 CPU와 GPU 코어를 먼저 비교하지만, 실제 사용 중 멈춤이나 스왑을 만드는 원인은 메모리 부족인 경우가 많습니다. 특히 AI 모델을 실행하면서 Docker 컨테이너와 브라우저 탭을 함께 열면 16GB와 24GB의 차이가 빠르게 드러납니다.
통합 메모리와 스왑
메모리가 부족하면 macOS는 SSD 일부를 가상 메모리로 사용하는 스왑을 늘립니다. 작업을 이어갈 수 있다는 장점은 있지만 SSD 접근은 RAM보다 느리므로, 모델 응답 속도와 전체 시스템 반응성이 크게 떨어질 수 있습니다.
스왑은 부족한 RAM을 보완하는 안전장치이지, RAM을 대체하는 기능이 아닙니다. 로컬 AI를 자주 사용할 계획이라면 스왑에 의존하기보다 모델 크기와 메모리 용량을 맞추는 것이 좋습니다.
RAM 용량별 추천 용도
| 통합 메모리 | 추천 사용자 | 실행하기 적합한 작업 | 구매 판단 |
|---|---|---|---|
| 16GB | API 중심 사용자 | Python, 웹 개발, 가벼운 3B~7B 모델, 문서 요약 | 예산이 제한적일 때만 추천 |
| 24GB | 로컬 AI 입문자와 개발자 | 7B~14B 양자화 모델, Docker, 워드프레스 자동화 | 기본 M4의 가장 균형 잡힌 선택 |
| 32GB | AI 에이전트와 배치 작업 사용자 | 14B급 모델, 긴 문서 처리, 여러 개발 도구 | M4에서 여유를 확보하는 구성 |
| 48GB | 로컬 LLM을 지속적으로 사용할 사용자 | 20B~30B급 양자화 모델, 여러 컨테이너, RAG | M4 Pro와 조합할 때 추천 |
| 64GB | 고급 개발자와 전문 사용자 | 30B급 모델, 복수 에이전트, 대규모 문서 분석 | 장기 사용과 확장성을 중시할 때 선택 |
16GB는 API 기반 AI 앱 개발이나 가벼운 모델 테스트에는 충분할 수 있습니다. 그러나 로컬 LLM을 상시 운영하고 브라우저, IDE, Docker를 함께 사용할 계획이라면 24GB가 훨씬 편합니다. 여러 컨테이너와 긴 컨텍스트를 자주 사용하는 경우에는 32GB 이상이 유리합니다.
모델 크기별 필요한 메모리
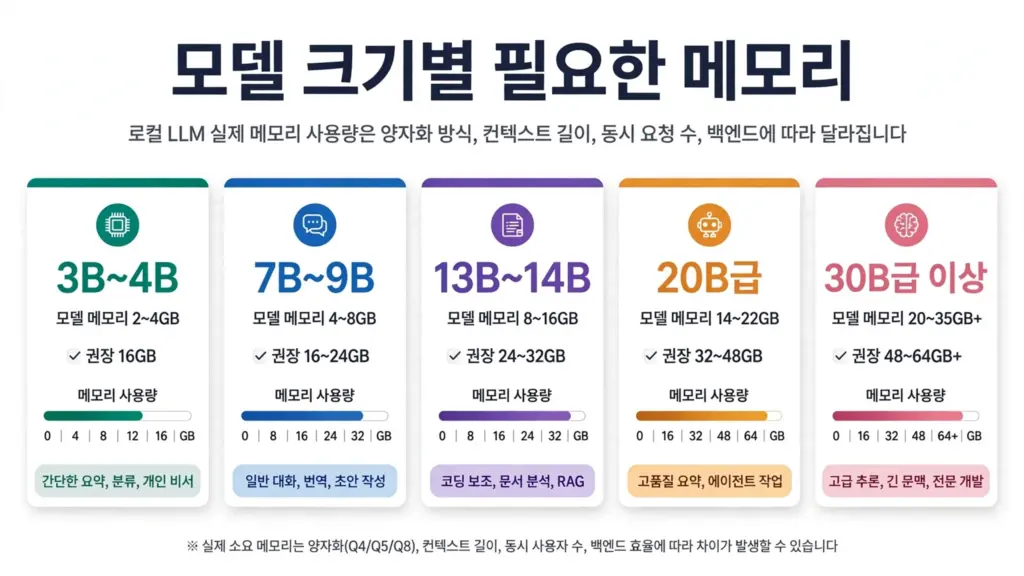
로컬 LLM의 실제 메모리 사용량은 모델 이름만으로 결정되지 않습니다. 양자화 방식, 컨텍스트 길이, 동시 요청 수, 백엔드, 모델 포맷에 따라 달라집니다.
| 모델 규모 | 대략적인 모델 메모리 | 권장 총 메모리 | 주요 용도 |
|---|---|---|---|
| 3B~4B | 약 2~4GB | 16GB | 간단한 요약, 분류, 개인 비서 |
| 7B~9B | 약 4~8GB | 16GB~24GB | 일반 대화, 번역, 초안 작성 |
| 13B~14B | 약 8~16GB | 24GB~32GB | 코딩 보조, 문서 분석, RAG |
| 20B급 | 약 14~22GB | 32GB~48GB | 고품질 요약, 에이전트 작업 |
| 30B급 이상 | 약 20~35GB 이상 | 48GB~64GB 이상 | 고급 추론, 긴 문맥, 전문 개발 |
위 수치는 4비트 양자화 모델을 기준으로 한 대략적인 범위이며, 모델 실행에 필요한 전체 메모리와는 다를 수 있습니다. 예를 들어 14B 모델 파일이 10GB라고 해도 macOS, 컨텍스트, 캐시, 프로그램 메모리를 추가로 고려해야 합니다.
검색 결과에서도 16GB는 7B급, 24GB는 양자화된 14B급, 48GB는 30B급 모델을 고려하는 기준으로 제시되지만, 실제 속도와 사용성은 모델별 테스트가 필요합니다.
추천 맥미니 구성
M4 16GB
Claude, ChatGPT, Gemini 같은 API 서비스를 주로 사용하고 로컬에서는 개발 환경과 가벼운 모델만 테스트할 예정이라면 M4 16GB도 사용할 수 있습니다. Python, Node.js, Docker 한두 개, 워드프레스 개발 서버 정도는 충분히 구성할 수 있습니다.
다만 메모리 업그레이드는 구매 후 불가능하므로, 로컬 LLM을 진지하게 고려한다면 16GB는 장기적으로 아쉬울 가능성이 있습니다.
M4 24GB
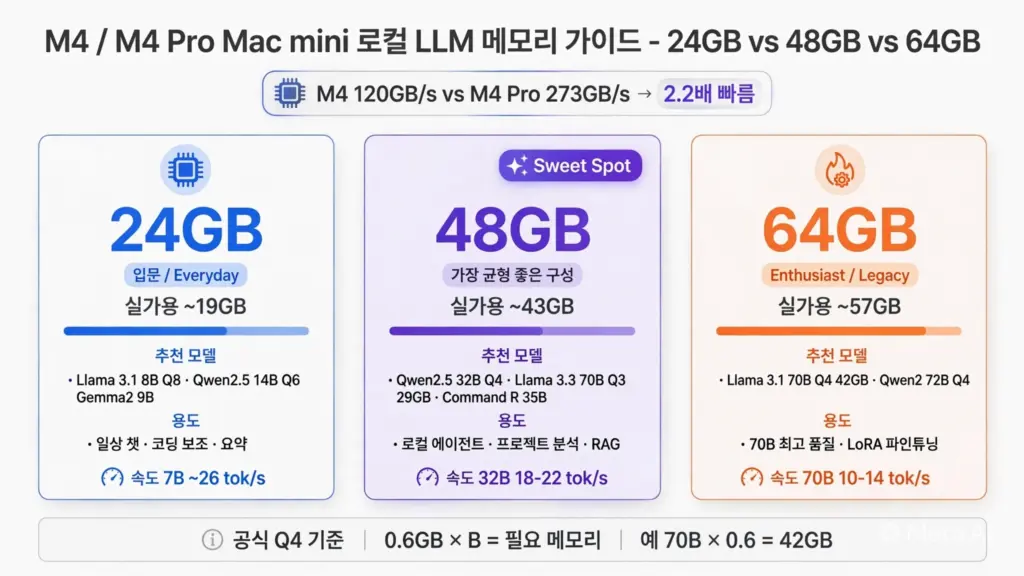
대부분의 사용자에게 가장 균형 잡힌 선택입니다. 로컬 7B~9B 모델을 쾌적하게 사용하고, 양자화된 14B 모델을 테스트하면서 Docker와 워드프레스 자동화를 함께 운영하기 좋습니다.
사용자의 콘텐츠 제작과 워드프레스 운영을 고려하면 M4 24GB, 512GB 구성이 실용적입니다. AI 초안 생성, 이미지 처리, 쇼츠 대본 자동화, 개발 환경을 한 기기에서 관리하려는 경우 시작점으로 적합합니다.
M4 32GB
기본 M4에서 메모리 여유를 우선하는 구성입니다. 긴 문서를 처리하거나, 로컬 AI 에이전트와 여러 컨테이너를 함께 운영하려는 경우 24GB보다 안정적입니다.
다만 20B~30B급 모델을 주력으로 사용할 계획이라면 메모리만 늘린 기본 M4보다 메모리 대역폭이 넓은 M4 Pro를 검토하는 편이 낫습니다. 로컬 LLM은 모델을 메모리에 올리는 것뿐 아니라 데이터를 빠르게 읽어야 하므로 대역폭도 체감 성능에 영향을 줍니다.
M4 Pro 48GB
로컬 AI를 구매 목적의 중심에 두고 있다면 가장 추천하기 쉬운 구성입니다. 20B급 모델, 일부 30B급 양자화 모델, RAG, Docker, 개발 도구를 함께 운영할 여유가 있습니다.
AI 코딩, 로컬 문서 검색, 개인 지식베이스, 자동화 에이전트를 장기간 사용할 계획이라면 M4 Pro 48GB가 M4 24GB보다 미래 대응력이 높습니다. 로컬 LLM 사용 빈도가 낮다면 가격 차이를 회수하기 어렵습니다.
M4 Pro 64GB
대형 모델을 직접 실행하거나 여러 AI 서비스를 동시에 운영하려는 사용자에게 적합합니다. 30B급 모델과 긴 컨텍스트, RAG 데이터베이스, IDE, 브라우저를 함께 사용하는 환경에서 메모리 압박을 줄일 수 있습니다.
다만 64GB라고 해서 모든 최신 대형 모델이 빠르게 실행되는 것은 아닙니다. 모델의 양자화 수준과 추론 속도, 메모리 대역폭, 발열, 소프트웨어 지원 여부를 함께 확인해야 합니다.
SSD와 네트워크 선택
로컬 AI 모델 파일은 생각보다 빠르게 저장공간을 차지합니다. 하나의 모델만 설치할 때는 256GB도 가능하지만, Ollama 모델 여러 개, Docker 이미지, 워드프레스 백업, 영상 원본까지 저장하면 금방 부족해집니다.
| SSD 용량 | 추천 상황 |
|---|---|
| 256GB | API 중심 개발, 외장 SSD 사용 전제 |
| 512GB | 로컬 AI 입문과 일반적인 개발 환경 |
| 1TB | 여러 모델, Docker, 백업, 콘텐츠 작업을 함께 운영 |
예산이 제한적이라면 RAM을 먼저 확보하고 SSD는 외장 NVMe로 보완하는 방법이 있습니다. 단, 외장 SSD는 케이블 분리, 절전, 발열, 백업 문제를 관리해야 하므로 중요한 모델과 데이터는 별도 백업이 필요합니다.
10Gb 이더넷은 대용량 파일을 자주 옮기거나 여러 장치에서 AI 서버에 동시에 접근할 때 유용합니다. 혼자 사용하는 홈서버라면 안정적인 1Gb 유선 연결만으로도 시작할 수 있습니다.
실무 팁: 맥미니 내부 SSD보다 RAM을 우선하세요. RAM은 나중에 교체할 수 없지만, 모델 파일과 백업 데이터는 외장 SSD나 NAS로 확장할 수 있습니다.
구매 전 체크리스트
구매 전 체크리스트
- 주력으로 사용할 가장 큰 모델의 크기를 정했는가
- 로컬 AI와 API 중 어느 쪽을 더 자주 사용할 것인가
- AI 실행 중 Docker와 IDE를 동시에 사용할 것인가
- 긴 문서와 긴 컨텍스트를 처리할 것인가
- 모델을 여러 개 설치할 SSD 공간이 있는가
- 외장 SSD와 클라우드 백업 계획이 있는가
- 24시간 운영 시 원격 접속과 자동 재시작이 가능한가
- 구매 후 RAM을 업그레이드할 수 없다는 점을 반영했는가
최종 추천 구성
API 중심 AI 개발: M4 16GB, SSD 512GB
로컬 AI 입문과 워드프레스 자동화: M4 24GB, SSD 512GB
로컬 LLM과 개발 환경을 함께 운영: M4 32GB, SSD 512GB 또는 1TB
20B~30B급 모델과 AI 에이전트: M4 Pro 48GB, SSD 1TB
대형 모델과 다중 작업: M4 Pro 64GB, SSD 1TB 이상
사용자의 목적이 맥미니에서 AI 콘텐츠 자동화, 워드프레스 관리, 로컬 LLM 테스트를 함께 하는 것이라면 M4 24GB 또는 M4 Pro 48GB를 기준으로 비교하는 것이 좋습니다. 로컬 모델을 가끔 테스트하는 수준이면 M4 24GB, AI 서버를 장기간 운영하고 여러 도구를 동시에 실행할 계획이면 M4 Pro 48GB가 더 적합합니다.
즉시 실행할 작업은 주력 모델을 7B, 14B, 30B 중 하나로 정하고 그 모델의 실제 파일 크기와 컨텍스트 사용량을 확인하는 것입니다. 모델이 정해지면 RAM 선택은 “예산이 얼마인가”보다 “남는 메모리가 얼마나 필요한가”를 기준으로 판단할 수 있습니다.